
我们正式推出新一代旗舰级文本转语音模型(Text-to-Speech,TTS)。它不是只为了做出好看的 Demo,而是面向真实产品环境打造:可以上线、可以扩展、可以切实提升用户和业务的生产力。作为一个真正的语音基座模型,它在可商用性、开源友好度与研究价值等方面都达到了行业领先水准。
在设计上,我们围绕语音生成最关键的三大要素展开:高质量的音频离散编码器(tokenizer)、大规模且高质量多样化的预训练数据,以及高效的离散 token 建模方法。这三者的组合,让模型在保持架构尽可能简洁(自回归范式)的同时,依然能够达到一流的生成效果——结构尽量简单,效果尽可能强。
模型概述
该模型在客观和主观评测中均达到了业界领先的语音合成质量,以语音克隆为核心能力,支持超长稳定语音生成、token级别的时长控制、多语言和代码切换合成,以及细粒度的拼音/音素级别发音控制——使其成为可扩展语音应用的生产级基础。
在核心层面,我们的模型通过三个最关键的因素实现语音生成的突破:高质量的音频tokenizer、大规模高质量且多样化的预训练数据,以及高效的离散token建模方法。这些要素结合在一起,让我们用一个出人意料简洁的配方达到了业界领先的性能:简单的自回归范式——架构尽可能精简,效果却强大有力。
以下是 MOSS Audio Tokenizer 的架构图:
MOSS Audio Tokenizer

MOSS Audio Tokenizer 是一个基于 Cat (Causal Audio Tokenizer with Transformer) 架构的 1.6B 参数量的音频 tokenizer。该模型旨在为自回归音频大模型提供统一的离散化音频接口,兼具无损重构能力与卓越的音频-文本语义对齐性能。详细细节请见 MOSS Audio Tokenizer。
以下是 MOSS-TTS 中使用的两种架构示意图。
Delay Pattern Vs. Local Transformer

为兼顾真实业务落地与学术研究,MOSS-TTS 选择同时训练并开源两套互补架构。左:Delay-Pattern(MossTTSDelay)。右:Global Latent + Local Transformer(MossTTSLocal)。详细细节请见 MOSS-TTS。
Benchmark
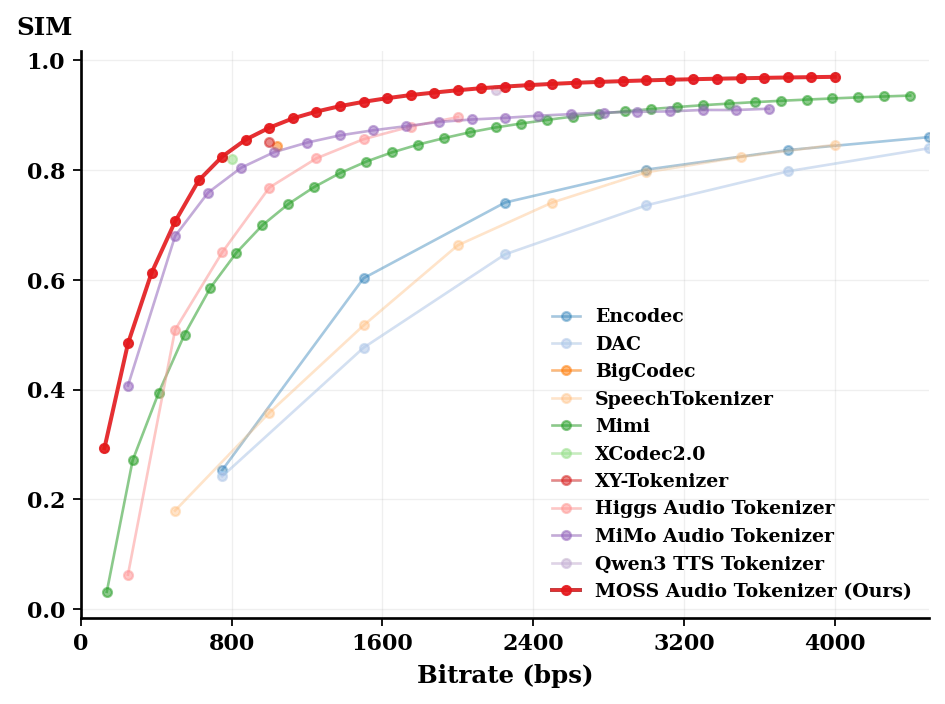
LibriSpeech 语音评测指标(MOSS Audio Tokenizer vs. 开源 Tokenizer)
下图对比了我们自研的 MOSS Audio Tokenizer 与其他开源语音 tokenizer 在 LibriSpeech test-clean子集上的表现,评估指标包括 SIM、STOI、PESQ-NB 和 PESQ-WB(数值越高越好)。在推理阶段,我们通过调整使用的 RVQ codebook 数量来控制同一模型的比特率(bps)。


TTS Model Comparison (Zero-shot Voice Cloning)
| model | params | open-source | en | zh | ||
|---|---|---|---|---|---|---|
| WER/%↓ | SIM/%↑ | CER/%↓ | SIM/%↑ | |||
| DiTAR | 0.6B | Closed Source | 1.69 | 73.5 | 1.02 | 75.3 |
| FishAudio-S1 | 4B | Closed Source | 1.72 | 62.57 | 1.22 | 72.1 |
| CosyVoice3 | 1.5B | Closed Source | 2.22 | 72 | 1.12 | 78.1 |
| Seed-TTS | - | Closed Source | 2.25 | 76.2 | 1.12 | 79.6 |
| MiniMax-Speech | - | Closed Source | 1.65 | 69.2 | 0.83 | 78.3 |
| CosyVoice | 0.3B | Open Source | 4.29 | 60.9 | 3.63 | 72.3 |
| CosyVoice2 | 0.5B | Open Source | 3.09 | 65.9 | 1.38 | 75.7 |
| CosyVoice3 | 0.5B | Open Source | 2.02 | 71.8 | 1.16 | 78 |
| F5-TTS | 0.3B | Open Source | 2 | 67 | 1.53 | 76 |
| SparkTTS | 0.5B | Open Source | 3.14 | 57.3 | 1.54 | 66 |
| FireRedTTS | 0.5B | Open Source | 3.82 | 46 | 1.51 | 63.5 |
| FireRedTTS-2 | 1.5B | Open Source | 1.95 | 66.5 | 1.14 | 73.6 |
| Qwen2.5-Omni | 7B | Open Source | 2.72 | 63.2 | 1.7 | 75.2 |
| FishAudio-S1-mini | 0.5B | Open Source | 1.94 | 55 | 1.18 | 68.5 |
| IndexTTS2 | 1.5B | Open Source | 2.23 | 70.6 | 1.03 | 76.5 |
| VibeVoice | 1.5B | Open Source | 3.04 | 68.9 | 1.16 | 74.4 |
| HiggsAudio-v2 | 3B | Open Source | 2.44 | 67.7 | 1.5 | 74 |
| GLM-TTS | 1.5B | Open Source | 2.23 | 67.2 | 1.03 | 76.1 |
| GLM-TTS-RL | 1.5B | Open Source | 1.91 | 68.1 | 0.89 | 76.4 |
| VoxCPM | 0.5B | Open Source | 1.85 | 72.9 | 0.93 | 77.2 |
| Qwen3-TTS | 0.6B | Open Source | 1.68 | 70.39 | 1.23 | 76.4 |
| Qwen3-TTS | 1.7B | Open Source | 1.5 | 71.45 | 1.33 | 76.72 |
| MossTTSDelay | 8B | Open Source | 1.84 | 70.86 | 1.37 | 76.98 |
| MossTTSLocal | 1.7B | Open Source | 1.93 | 73.28 | 1.44 | 79.62 |